我们常常遇到一种情况,我们的 Agent Context 上下文达到一定长度时候就会变得奇蠢无比。即使宣传的是 1M 上下文长度,其实实际能用的也是大概200K左右,超出这个范围,AI 的智力水平就开始直线下降。
什么是上下文腐化
上下文腐化(Context Decay) 是指:随着对话轮次或任务步骤的推进,早期注入的关键信息因被后续内容稀释、截断或注意力分散,逐渐失去对模型推理的有效影响,导致智能体行为出现退化、漂移或自我矛盾的现象。
为什么会导致上下文腐化
要想要理解什么是上下文腐化,我们就要从 Transformer 架构的 注意力权重机制说起。
在 Transformer 中有一个核心的 注意力计算公式
其中有三个参数 Q(Query|哪个词和我最相关?), K(Key|每个词对应的类型标签), V(Value|这个词的语义信息)。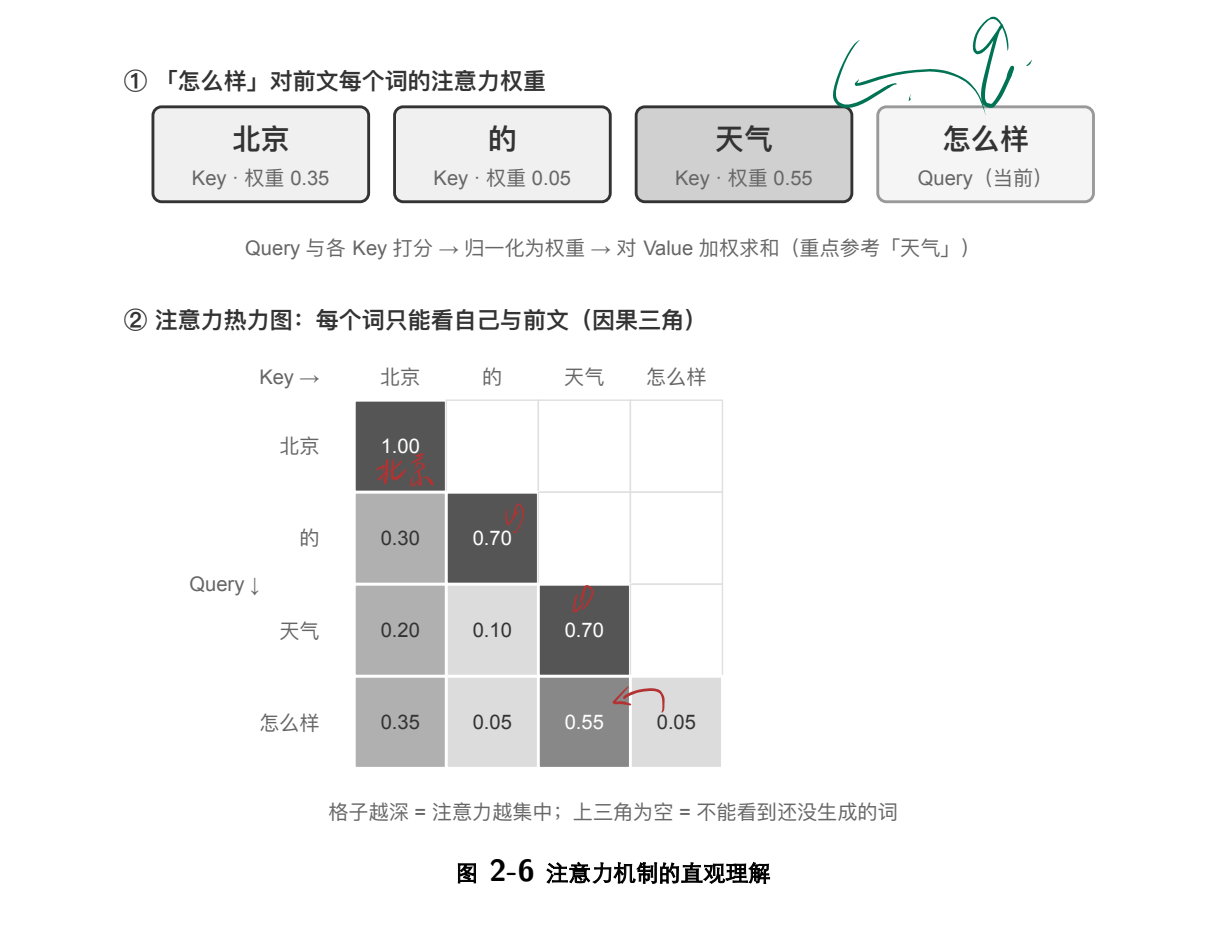
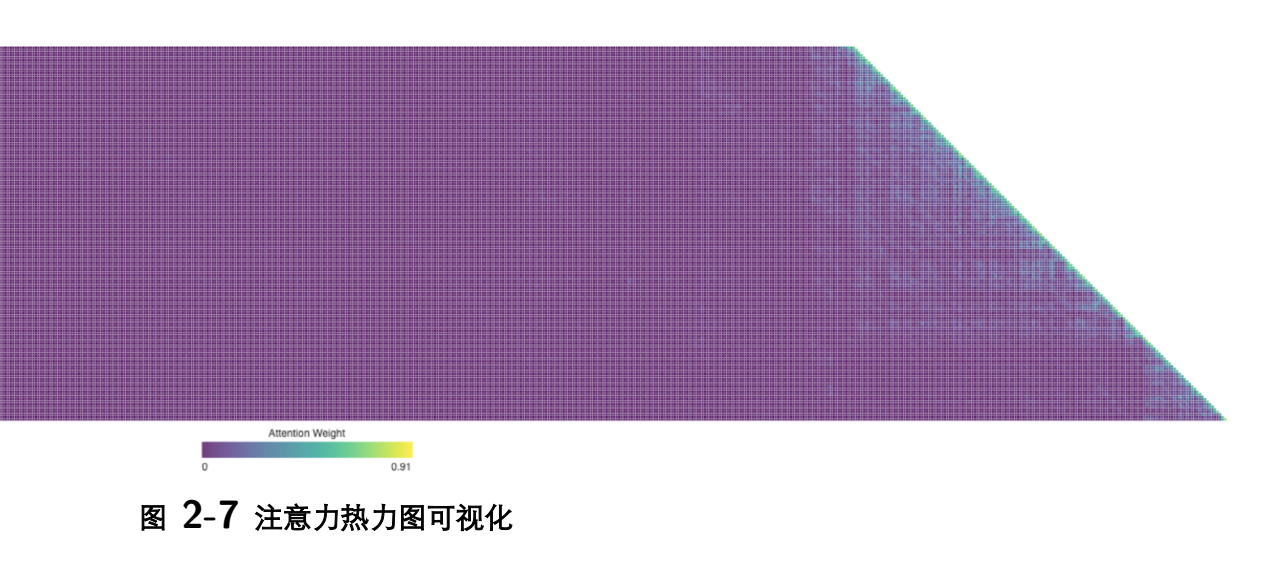
上面这两张图则展示了注意力机制的每个词的关注点。
同时揭示出几个关键模式:
- 序列的第一个 token 往往吸收了异常高的注意力权重,不过这不是模型缺陷,这是将无处安放的注意力权重倾倒到第一个token上,我们称之为 "注意力存储池"
- 位置偏好:模型对上下文的开头和结尾的信息分配了更高的注意力权重,而中间部分的权重则有所降低。
Lost-in-the-Middle 效应
斯坦福大学 2024 年的研究证实:大语言模型对上下文窗口中段信息的注意力显著低于头部和尾部。这意味着将关键信息放置在上下文中间,是最糟糕的设计决策——即便它在窗口内,也可能被模型实质性地忽视。上下文工程的一个核心原则是:**最重要的信息,始终放在开头或结尾。
回到我们讨论的上下文腐化问题,虽然模型的上下文长度可以达到1M,但是上下文长度一旦达到一定长度时候,其中过多的无关信息就会稀释模型对关键内容的注意力。模型注意力会放在 context 的开头与末尾,中间的注意力权重将会明显下降。
这就会导致一个问题:明明上下文窗口还远没有满,但Agent找不到关键信息,反复揪着一个早已解决的问题不撒手。因为他的解决问题的上下文在窗口中间位置,过低的注意力权重稀释了关键信息,最终诱发上下文腐化。
对于 Agent 使用者的建议
我们了解了 上下文腐化 的原因后,我们就可以尽量去避免上下文腐化问题。
- 尽量不要一个 session 会话执行过多杂乱的任务。
- 尽量不要将 context 占用处在较高的位置,尽量将上下文占用保持在 20%~30% 之间,在这个区间的模型智力最高,超过这个区间的注意力可能就会被稀释。
对于Agent相关开发者
解决上下文腐化问题的手段之一就是进行良好的 上下文管理。
必要时候进行上下文压缩,将不必要的无关内容进行提炼总结压缩。
上下文管理方面我们可以用通用结构:
System Prompt -> Tool Definitions -> History (Tools Calls Response、 User, Assistant Resp) -> etc
作者水平有限,如有错误欢迎指正批评。